AI 能落地真实工程吗?RWE-bench 测评解读
Xplore 用曲轴设计、DDR3 布线、涡轮导叶 CFD 等 20 个真实工程任务测试 11 个模型,由物理校验程序判分,最高通过率仅 37%。本文解读它测了什么、结果多可信,以及这个基准想证明什么。
文章目录
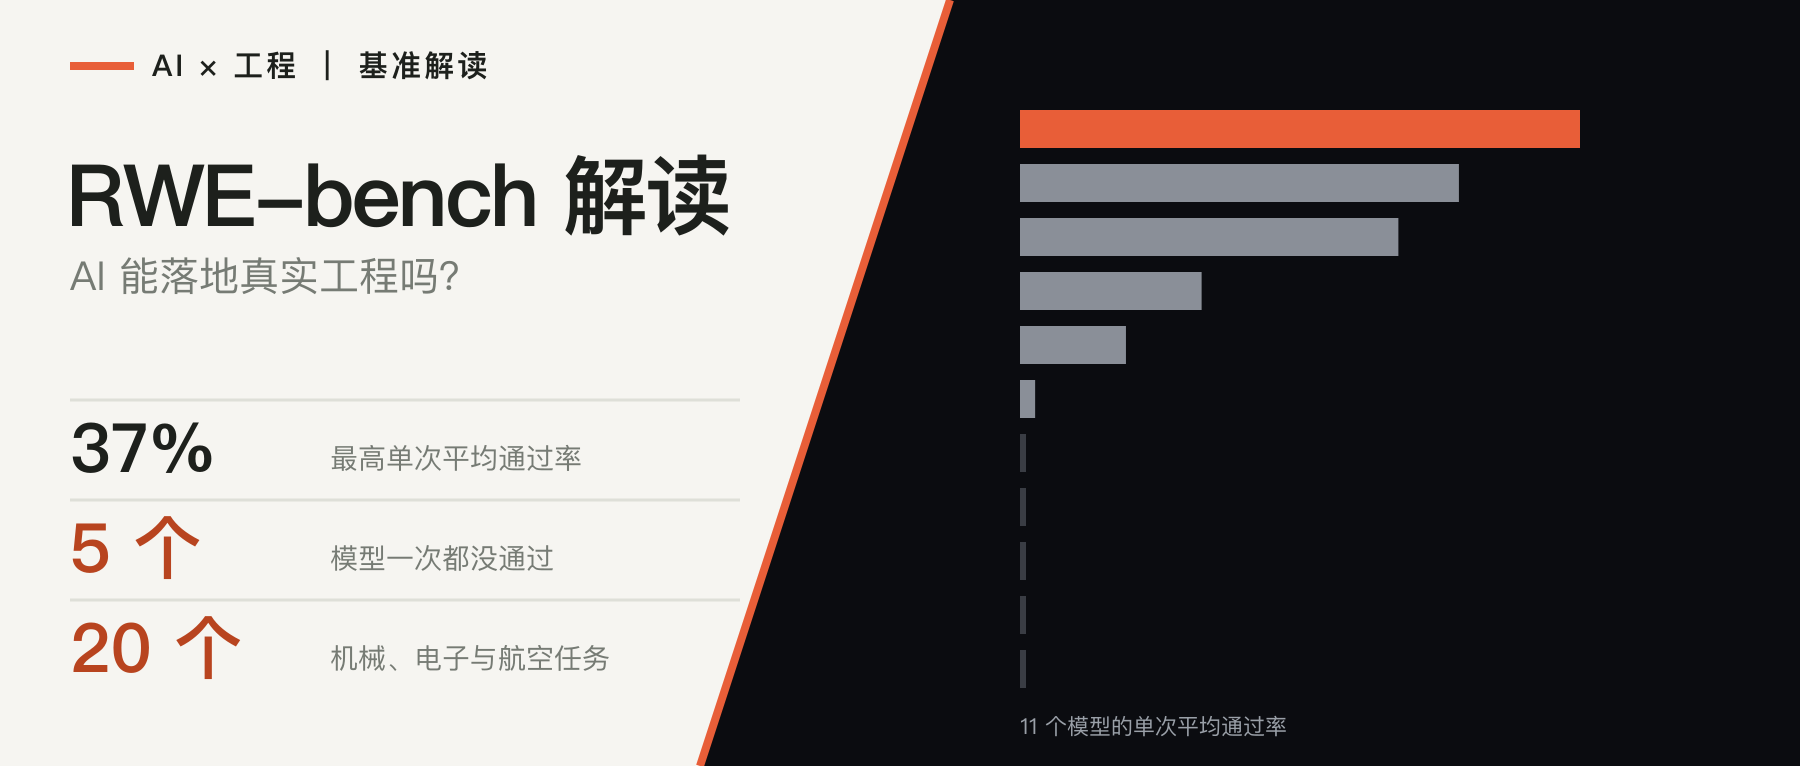
2026 年 10 月 27 日,工程 AI 初创公司 Xplore 发布 RWE-bench(Real World Engineering Bench,真实世界工程基准):用 20 个机械、电子和航空航天工程任务测试前沿大模型,所有结果由确定性的物理校验程序自动判定。11 个首发模型中,表现最好的 GPT-6 Astra 平均通过率为 37%,另有 5 个模型一次都没有通过。
测了什么
Xplore 的官方页面列出了三类任务:
- 机械工程,9 个任务:在 CAD 中建模零件和机构,校核强度、配合与运动,包括曲轴等发动机零件、面向制造的钣金件和 3D 打印机构。
- 电子工程,5 个任务:在元件已布好的高密度电路板上做高速 PCB 布线,包括 DDR 内存和 PCIe 链路,需满足等长、时序偏差(skew)和阻抗要求。
- 航空航天工程,6 个任务:从划分网格到求解收敛的 CFD(计算流体力学)与共轭传热分析,对象包括涡轮导叶及其气膜冷却、飞机机翼、火箭喷管和冷却通道。
官方公开了三个示例任务:
- 曲轴设计:为一台 3 缸柴油机在 CAD 中设计带油孔的整体钢制曲轴。曲轴要装得上给定的轴承、飞轮和前端传动,旋转时不能碰到连杆;平衡块既要平衡曲轴,又不能超出质量限值。在 2,400 rpm 满负荷点火工况下,应力、刚度和轴承载荷都要在限值内,并能承受数百万次循环而不发生疲劳失效。
- DDR3 布线:在一块量产 FPGA 板上完成 DDR3L 内存接口布线。这是一条从 Zynq-7000 到 2 颗内存芯片的 32 位 fly-by 总线,涉及 484 球 BGA 引出的 71 个网络,板子共 8 层,已放置约 300 个元件,其余网络已布好且不能改动。数据线、地址线和命令线都要满足各自的时序偏差预算,所有走线还要保持目标阻抗。
- 涡轮导叶 CFD:预测高压涡轮导叶周围的换热。智能体要自己建立导叶周围流道并划分网格,把 CFD 求解到收敛,再报告叶片表面的换热系数分布和总热负荷。
怎么判分
按 Xplore 的说明,每个任务由团队中对应领域的工程师出题,同时编写校验程序,并用与智能体相同的工具做出一份满足全部要求的参考解。
- 智能体拿到一份技术任务书,在沙盒里用 CAD/CAE 工具工作,每次尝试最长 24 小时,可以在提交前自己做验证。
- 提交后由确定性程序检查每一项要求,必要时会运行物理求解器,全部满足才算通过。判分不使用 LLM 评审,也没有人工打分。
- 每个模型在各自厂商的原生智能体环境中运行(例如 Codex、Claude Code、Gemini CLI),推理强度设为最高。每个模型在每个任务上跑 5 次。
结果
以下为官方页面截至 2026 年 10 月 28 日的数据。通过率为单次尝试的平均值,括号内为 95% 可信区间;成本为每次运行的平均 API 花费。
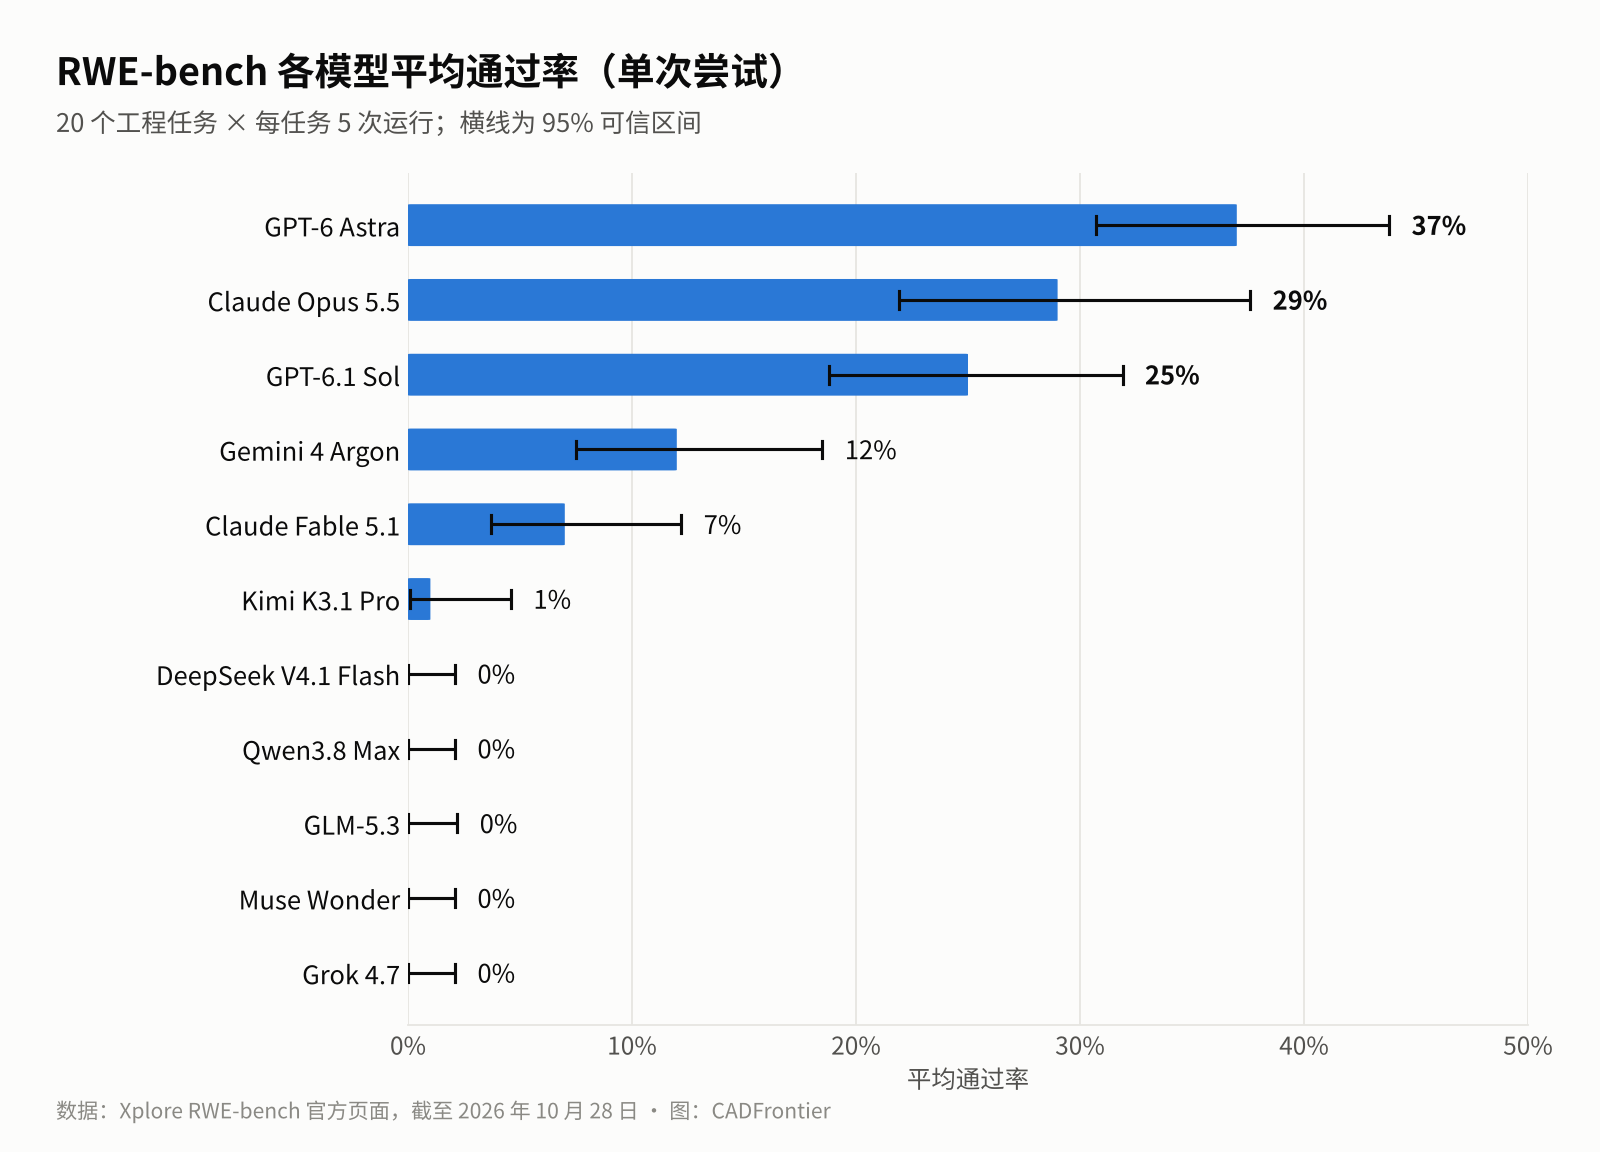
图 1:各模型单次尝试的平均通过率与 95% 可信区间。数据来自 Xplore 官方页面,图表由 CADFrontier 绘制。
| 模型 | 智能体环境 | 平均通过率 | 每次运行成本 |
|---|---|---|---|
| GPT-6 Astra | Codex | 37%(30.7–43.8%) | $58.83 |
| Claude Opus 5.5 | Claude Code | 29%(21.9–37.6%) | $57.52 |
| GPT-6.1 Sol | Codex | 25%(18.8–31.9%) | $10.28 |
| Gemini 4 Argon | Gemini CLI | 12%(7.5–18.5%) | $23.66 |
| Claude Fable 5.1 | Claude Code | 7%(3.7–12.2%) | $97.57 |
| Kimi K3.1 Pro | Kimi Code | 1%(0.1–4.6%) | $71.20 |
| DeepSeek V4.1 Flash | DSH | 0%(0–2.1%) | $1.03 |
| Qwen3.8 Max | Qwen Coder | 0%(0–2.1%) | $17.40 |
| GLM-5.3 | ZCode | 0%(0–2.2%) | $22.66 |
| Muse Wonder | Muse Code | 0%(0–2.1%) | $27.56 |
| Grok 4.7 | Grok Build | 0%(0–2.1%) | $66.27 |
官方页面还给出几组数字:
- 如果允许尝试 5 次、只要有一次通过就算成功(pass@5),Claude Opus 5.5 能通过 70% 的任务。
- 在全部 1,100 次运行中,有 4 个任务从未被任何模型通过。
- 每次运行平均耗时 3.4 小时,耗时更长并没有带来更好的成绩。
- 成本与成绩也不成正比:GPT-6.1 Sol 每次运行约 10 美元,通过率只比前两名低 4 到 12 个百分点,而前两名的成本接近它的 6 倍。
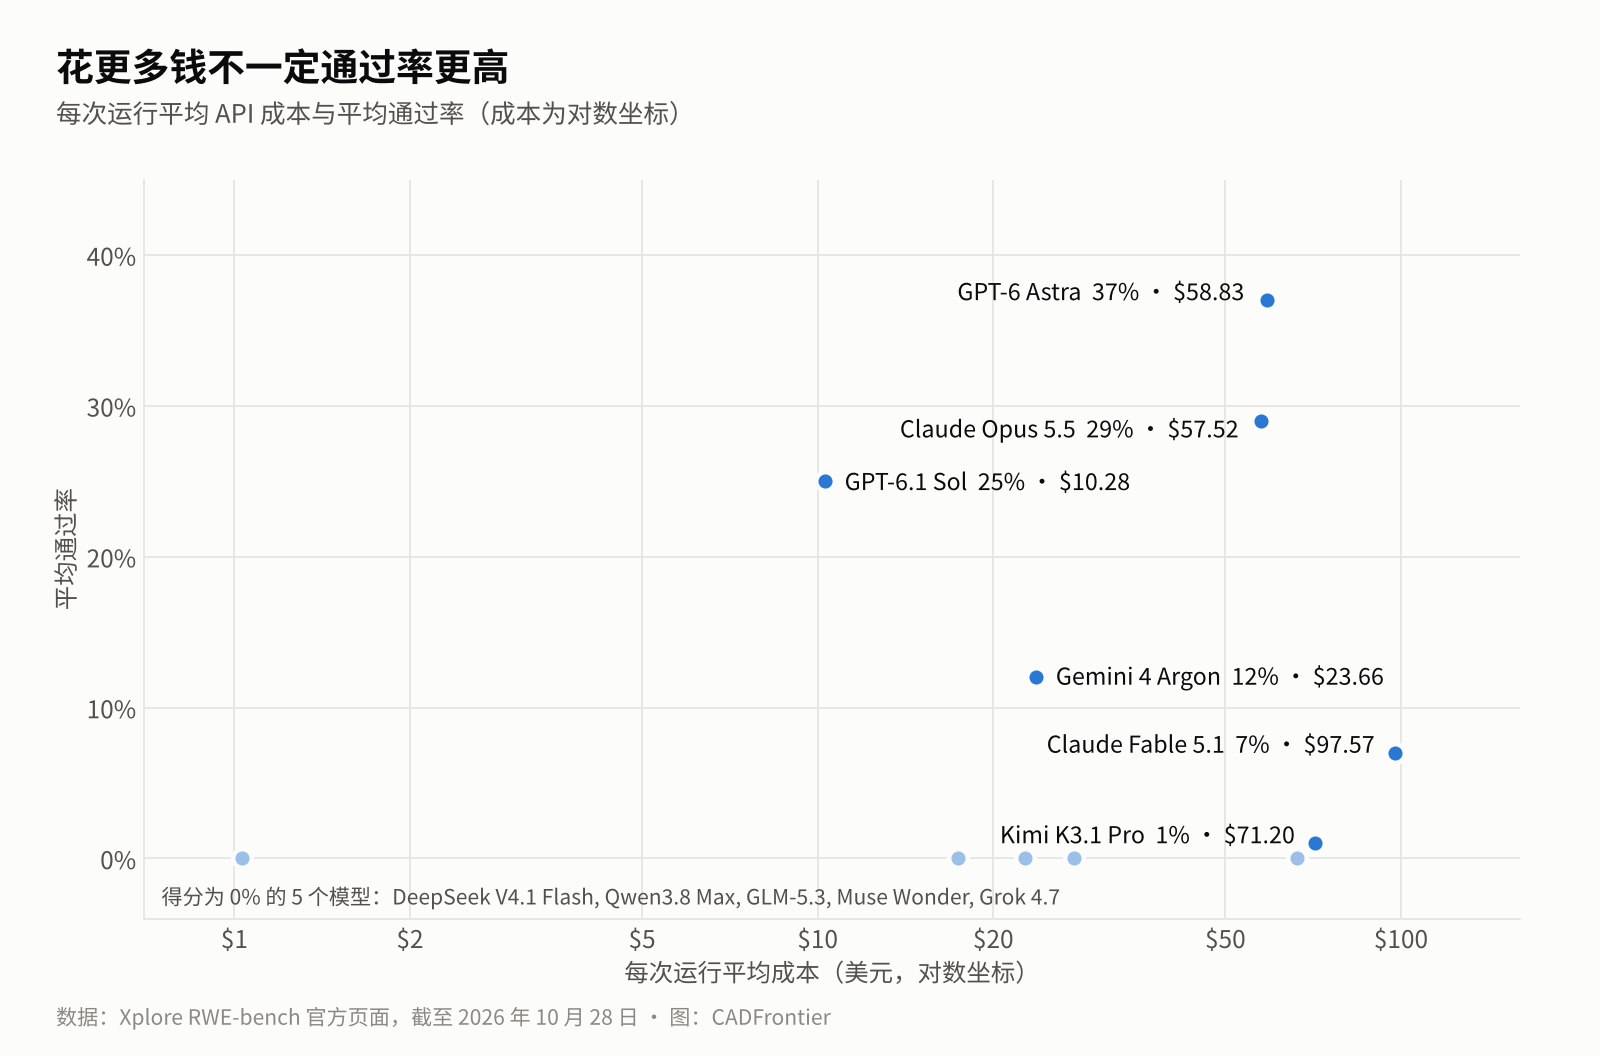
图 2:每次运行平均 API 成本与平均通过率。数据来自 Xplore 官方页面,图表由 CADFrontier 绘制。
对 CAD 工程师意味着什么
这里的 CAD 是代码建模,不是主流 MCAD 的特征树。 官方曲轴示例列出的工具是 CadQuery、Gmsh、CalculiX 和 Python,都是开源、可脚本化的建模、网格和有限元工具,并不是 SolidWorks、NX 或 Creo 这类交互式参数化软件。页面没有说明电子和航空任务用了哪些工具。因此,“通过”意味着设计满足物理校验,不代表模型能在常用 CAD 软件里交付可编辑的原生特征历史。两者的区别可参考本站《AI 走进 CAD,真正的变化发生在特征树里》。
能做对,但还不稳定。 单次通过率最高 37%,Claude Opus 5.5 尝试 5 次却能通过 70% 的任务。这说明模型有时能完成完整的工程闭环,但单次结果不可靠。工程落地仍然需要可重复的自动校验和工程师复核。相关讨论见本站《让工程智能体可靠执行,为什么每一步都要验证?》。
评测的是“模型加智能体环境”的组合。 每个模型都在自家的智能体环境中运行,所以分数同时反映模型和配套工具链的表现,不能直接当作模型本身的能力排名。
限制
- 规模小:只有 20 个任务,置信区间较宽。前两名的区间有重叠(30.7–43.8% 与 21.9–37.6%),第一和第二的先后并非决定性结论。
- 不能独立复现:任务和校验程序没有公开,外部只能联系 Xplore 参与评测。
- 出题方有商业利益:Xplore 同时提供强化学习训练环境,基准与其业务直接相关,详见下文结论。
- 结果可能更新:表中数据为官方页面截至 2026 年 10 月 28 日的版本,模型名称按官方写法照录。
结论:这个基准想证明什么
按 Xplore 的说法,RWE-bench 有两个目的。
第一,量化差距。 AI 在数学和编程上已经超过大多数人,却还不能可靠地解决需要同时平衡几何、应力、热和阻抗的工程问题。最高 37% 的通过率,加上 5 个得 0% 的模型,就是给这个差距一个可以测量的数字。
第二,证明工程也能像代码和数学一样训练。 Xplore 在公司宣言中提出:代码和数学进步快,是因为结果可以自动验证,模型能通过带可验证奖励的强化学习(RLVR)大规模练习。工程结果同样可以验证,例如涡轮叶片要么满足温度和应力限值,要么不满足。在 Xplore 看来,真正缺的是数据:真实的工程问题、真实的工具和防作弊的校验,目前大多留在企业内部和资深工程师的经验里,不像代码那样存在于公开仓库中。RWE-bench 只用确定性程序和物理求解器判分,本身就是在演示这种“可验证”的做法。
这两点也决定了它的商业角色。官方页面提供两项服务:一是为模型厂商做评测,二是用同样的方法构建强化学习训练环境(基准任务本身不授权用于训练)。所以 RWE-bench 既是测量工具,也是 Xplore 训练环境业务的展示:先证明差距真实存在、而且可以精确测量,再提供补上差距所需的数据。
对工程师来说,这份结果说明:AI 已经能在部分真实工程任务中跑通“建模、网格、求解、校核”的完整流程,但单次成功率不到四成,用的也是代码化的开源工具链。就目前的数据看,它更接近需要工程师把关的助手,还不能独立交付设计。