图纸转 3D,AI 能考几分?CADBench 测评解读
CADBench V3 的 40 道图纸题在 FreeCAD 中测试特征树建模。结合 2026 年 9 月成绩快照,拆解评分、模型与 Agent 的差异,以及分数对工程交付的适用边界。
原载「AI驱动产品设计」,资料口径截至 2026-10-18;本站整理复刊时保留原稿观点与数据快照,不代表当前排行榜或产品承诺。
本文解读 gNucleus 的 Parametric CAD Bench(cadbench.ai,下称 CADBench)V3。数据以官方页面和公开任务包为准,截至 2026 年 10 月 18 日;观点部分是我的判断。
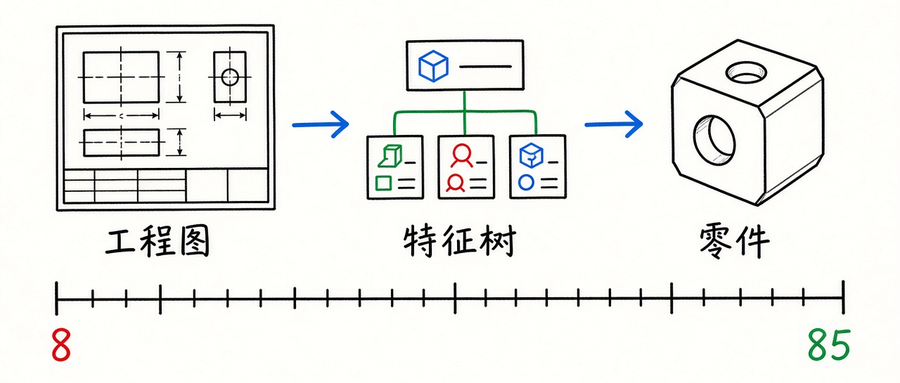
第 02 篇写过 Normal 的 CAD Arena:18 张图纸,让大模型在 NX、SolidWorks、Onshape、Fusion、Build123d 五个平台上建可编辑特征树,综合分最高约 0.75,短板常是“画得出、改不动”8。CADBench V3 是另一家的同类测评,设定不同:只在 FreeCAD 里测;100 道题里 40 道只给工程图、不给文字参数表;评分用几何与尺寸的调和平均,失败记 0 13。成绩单上,文字建模各组差约三十多分,图纸题从约 8 分拉到约 85 分 2。这篇只谈图纸转 3D 这一项。
一、题目:只给图,要建特征树
我下载了公开任务包看题 5。每题一张 A3 工程图,有主视、俯视、侧视、剖视和轴测,标尺寸、孔(如 4×Ø3.5),附通用公差表和粗糙度符号。零件多是舵机安装座、支架、带轮、外壳、连杆这类中小件。
任务写明:图纸是唯一几何来源,没有文字描述,也没有参数表。Agent 要写 FreeCAD Python 脚本,生成只含一个 PartDesign Body(零件设计体)的文件,由特征树得到单一实体;直接存一个没有特征历史的实体不算 5。PartDesign 是“草图 + 特征”的路子,对应主流 CAD(NX、SolidWorks、Creo)里的拉伸凸台、拉伸切除、阵列等。考的不是“画个外形”,而是在真实 CAD 里搭出一棵特征树。
运行条件很死:每题限时 9,000 秒,只跑 1 次;Agent 除调用模型接口不能联网;参考模型在隔离的评分环境里;失败一律记 0 3。
二、评分:形状和尺寸,两边都要对
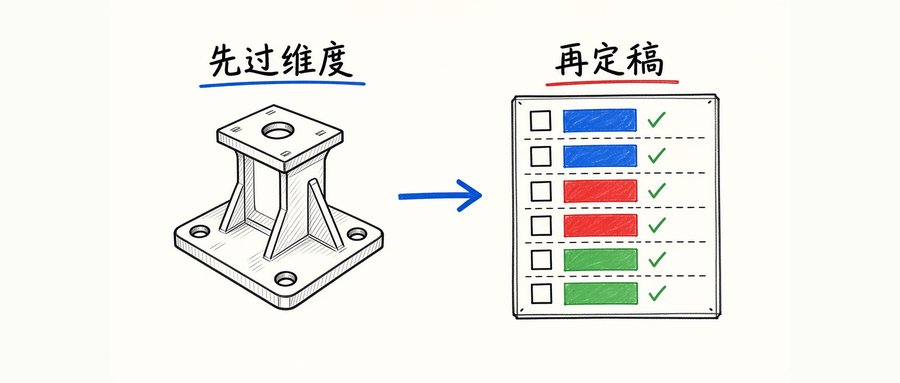
每题得分在 0 到 1 之间,由几何相似度和尺寸一致性取调和平均;任何一项为 0,总分就是 0 56。
几何:先比贴合零件的最小外框(OBB)三个边长,误差达到 10% 直接记 0。过了这关,再比体积、表面积等,并把两边各个面的中心点对齐,检查特征位置 6。
尺寸:评分方给每张图准备了隐藏尺寸表。40 张图,每张 9 到 118 个尺寸,合计 1,446 个;其中约一成绑定到具体几何位置,其余在草图、特征参数和实体几何里找同类、数值最接近的一个,相对误差 1% 以内算对 56。每错或漏一个扣 0.1,错满 10 个,尺寸分归零。图上的通用公差和粗糙度,我在 40 份表里没找到对应检查项 5。
我的理解:孔位画错,两边都会扣,比只看外形严格;但多数尺寸是“按数值找最接近”,同一个数出现在别处也可能被算对。
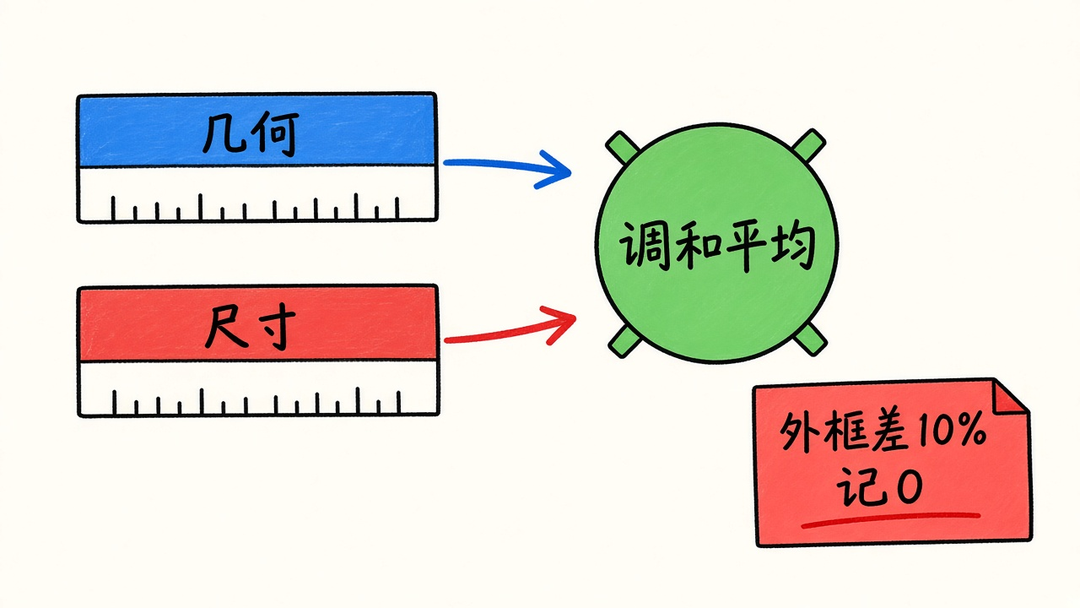
图 1:CADBench 图纸题的评分方式(AI 生成示意图)
三、成绩单:图纸题把差距拉开
排行榜快照为 2026 年 9 月 24 日,共 13 组“模型 + Agent”2。按图纸题节选:
- Claude Opus 5.5 — Agent:Claude Code;图纸转 3D:84.66;文字新建:50.87;综合:61.03
- Claude Opus 5.5 — Agent:mini-swe-agent;图纸转 3D:81.77;文字新建:42.79;综合:57.96
- Claude Fable 5.1 — Agent:Claude Code;图纸转 3D:72.71;文字新建:55.48;综合:56.75
- GPT-6 Astra — Agent:Codex;图纸转 3D:69.70;文字新建:52.26;综合:56.87
- Claude Opus 5 — Agent:Claude Code;图纸转 3D:62.64;文字新建:49.48;综合:50.86
- Gemini 3.8 Flash — Agent:mini-swe-agent;图纸转 3D:31.10;文字新建:47.94;综合:36.19
- Grok 4.7 — Agent:Grok Build;图纸转 3D:26.91;文字新建:45.57;综合:34.82
- Gemini 3.8 Flash — Agent:Antigravity;图纸转 3D:17.45;文字新建:43.28;综合:27.56
- Kimi K3 — Agent:mini-swe-agent;图纸转 3D:15.36;文字新建:39.11;综合:24.92
- Grok 4.6 — Agent:Grok Build;图纸转 3D:13.00;文字新建:41.61;综合:27.72
- GPT-5.6 Terra — Agent:Codex;图纸转 3D:8.18;文字新建:23.32;综合:17.24
注:0–100 分;另有 30 道文字改模题未列。公开榜上明确的国内模型为 Kimi K3(月之暗面);未见 DeepSeek、Qwen、豆包等。来源:2。
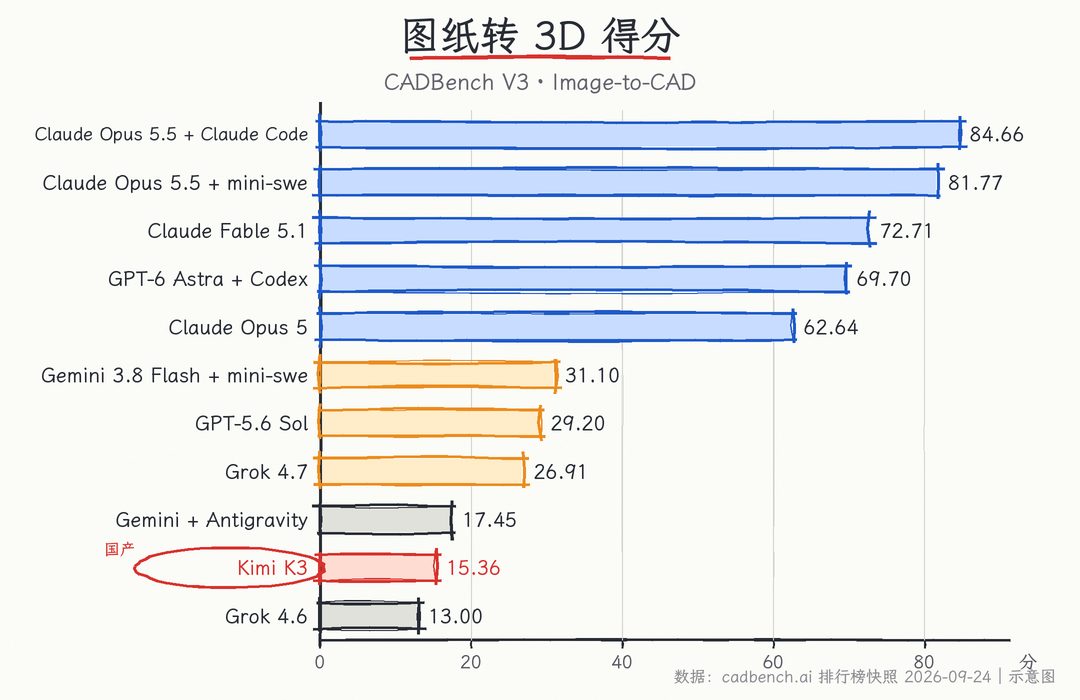
图:CADBench V3 图纸转 3D(Image-to-CAD)得分对比(手绘白板示意图)。数据来源见上表。
我按 13 行算:图纸题最高 84.66、最低 8.18,差 76.48 分;文字新建差 32.16 分;文字改模差 21.14 分。前 5 组的图纸分高于文字分,后 8 组全部相反 2。图纸题占 40 道,综合排名基本由它决定。官方也提醒,综合分前 4 名的 95% 置信区间互相重叠,排序不宜读成显著差异 4。
四、差距从哪来:会不会看图,图有没有真的进模型
分差这么大,主要卡在两件不同的事上。第一件是会不会看图:模型自己能不能认视图、读尺寸、对到特征上。第二件是图有没有真的进模型:外面的程序(Agent)有没有把工程图当成图片,塞进多模态接口——送进去的是像素,不是文字描述。下面用两组对照说明。
换模型、不换 Agent。 同样用 Claude Code,Opus 5 换成 Opus 5.5,图纸题涨 22.02 分,文字新建只涨 1.39 分;整套成本反而降了 43.3% 4。我认为这与模型认视图、读小字号尺寸、把尺寸对到特征上的能力提升一致;但该测试并未隔离所有影响因素,不能据此证明单一因果机制。
换 Agent、不换模型。 同一个 Gemini 3.8 Flash:mini-swe-agent 能把图纸当图片直接送给模型,图纸题 31.10 分;Antigravity 是 17.45 分,平均高 13.65 分(配对 95% 区间 5.55–21.75)。官方说明两边的提示词和工具协议都不同,不是严格对照 3。反过来,Opus 5.5 换两个 Agent,图纸题只差 2.90 分 4。这两组结果说明模型能力与 Agent 的图像传递、工具和提示流程都会影响成绩;不能据此认定低分配置从未把原图传给模型,也不能把小样本差异推广为所有 Agent 的普遍规律。
把图送进模型也会出错:Gemini 有 6 道题在原图已正确传入后,把后续派生图片的报错文字当成图片发出,接口拒收,记 0 3。5 月报告还写过,分数高的 Agent 每次重算后打印体积核对,低的那个切除方向设反却没发现 7。
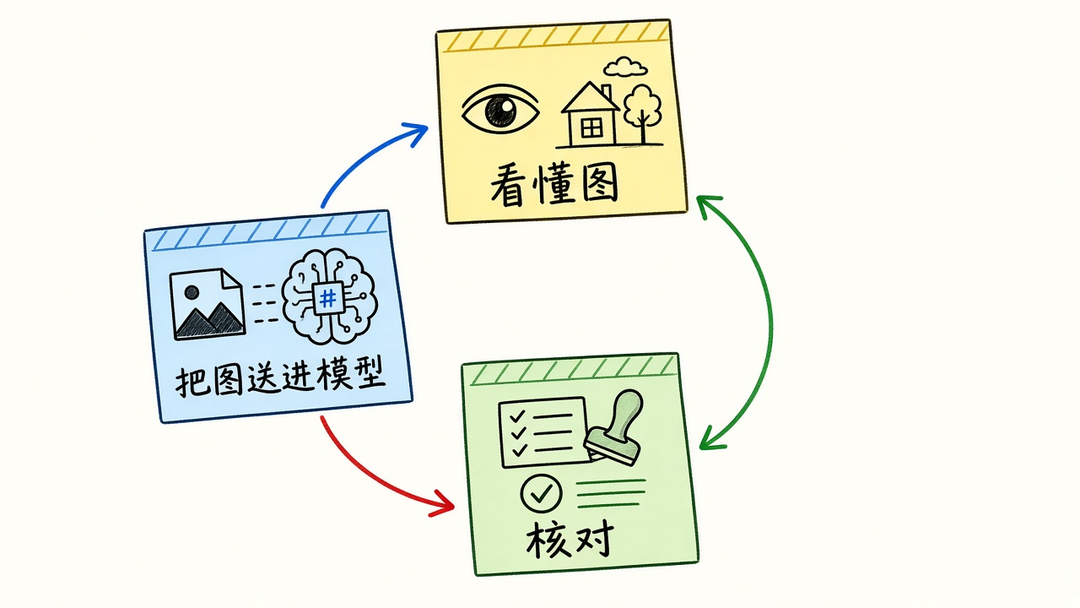
图 2:看懂图、把图送进模型、核对(AI 生成示意图)
五、测试解读
从这张 CADBench V3 图纸题成绩单,我读出这几条:
- 能做初版,不能当交付。 最好的组合在规整工程图上平均 84.66 分:形状和尺寸大体对的特征树零件可以期待;不查公差与配合、不查特征好不好改,仍要工程师校核 25。
- 看图能力影响成绩。 同样用 Claude Code,Opus 5 → Opus 5.5,图纸题涨 22 分、文字新建几乎不动;这与认视图、读尺寸和对应特征的能力提升一致,但不能证明只有这一个影响因素 4。
- 图像和工具接口影响成绩。 同一 Gemini 3.8 Flash 的两种配置图纸题相差 13.65 分;但提示、协议和服务路径并不相同,不能把全部差异归因于原图是否传入 3。
- 核对要写进流程。 高分 Agent 常在重算后打印体积等做自检;低分组切除方向反了却没发现。对应第 07 篇说的「反复对照原图」——最小一步就是每次改完量一下 7。
- 测的是闭环第一段。 第 07 篇方案是:主流 CAD 里经 MCP / API 搭特征树 → 对照原图 → 属性 / 出图 / 入库 → 人审。CADBench 图纸题只覆盖「脚本接口照图建特征树」;后面几段本次未测。
- 和 CAD Arena 方向一致、分数不能直接比。 口径不同;排序上 Opus 5.5、Astra、Fable 5.1 都靠前 28。
- 不能将单一国内模型条目推广到所有国产模型。 公开榜明确的国内模型目前是 Kimi K3:图纸 15.36、综合 24.92,与榜首约 85 / 61 差距大;未见 DeepSeek、Qwen、豆包等 2。缺席模型的表现不能从本榜推断。
本文配图为原稿的概念示意,不是产品实测截图。英文版使用对应英文配图,图内文字与图注均为英文。
延伸阅读:工程智能体与 CAD 工作流。