AI 实现零件装配要素的评价:FrontierCAD 报告解读
FrontierCAD 通过几何夹具与相对位姿评价零件和装配。本文结合评分、测试成绩、选题偏差与临时装配评分的局限,讨论它能检查什么、不能证明什么。
原载「AI驱动产品设计」,资料口径截至 2026-10-10;本站整理复刊时保留原稿观点与数据快照,不代表当前排行榜或产品承诺。
【AI 行业速递】|阅读约 7 分钟
本文编译自 Normal 的研究文章《FrontierCAD》(https://normal.ai/research/frontiercad),数据与结论以原文为准,文中观点部分为我的解读。
这篇文章对应结构设计里的详细设计 → 装配与配合。螺栓孔能否对上、零件能否摆到位,靠外形相似度回答不了。FrontierCAD 一道题让 AI 按工程图重建零件,另一道题让 AI 根据装配图摆放现成零件,再由评测器检查结果。标题中的“识别装配要素”,指评测器从参考零件提取可检查的几何区域,不等于 AI 已经理解整套装配关系。我想看清它能查出什么、还漏掉什么。
研究列表页的日期是 2026 年 10 月 5 日,作者是 Aayush Gupta、Pav Saini、Anson Yu、Hudhayfa Nazoordeen。测试为 7 个模型、39 个零件、16 个装配,每题 1 次,成绩来自 2026 年 9 月 19 日的运行 123。
一、两道题,都在问装不装得上
零件题读工程图,交出一个 STEP 实体。装配题拿到各零件的 STEP 和一张装配图,图上有带公差的尺寸、物料清单和气球号,模型只把零件挪到位。Normal 写明,选零件、加配合和紧固件、检查运动,都还没有发布 1。
图纸是否够用,用人工重建核对。CADQuests 上的人在 2026 年 7 月和 8 月只用 Onshape、只凭图纸重建,参考件相差 3% 以内才收下。同一评分器下,39 个零件的人工平均分是 0.691,只有 1 个过线,建模时间中位数 84 分钟。原文说这是基线不是上限,图纸不会把倒角、退刀和内部细节都规定死 2。
二、只比外形,会放过装不上的零件
原文用受控改动试了现有评分器,指出两个问题 1。
第一个是方向。图纸通常不规定零件怎么摆。做对了但转了角度,固定方向去比就会扣分。4 个零件从 0.1° 转到 90°:CADGenBench 在 1° 时掉到 0.81,BenchCAD 在 90° 时掉到 0.12,CADBench 从 0.96 到 0.99,变化最小。FrontierCAD 每个角度都是 1.000。BenchCAD 这次把特征分设为 0,所以到不了 1.0。这组试验不是事先留出的:旧评分器曾把一个转角打成 0.750 1。
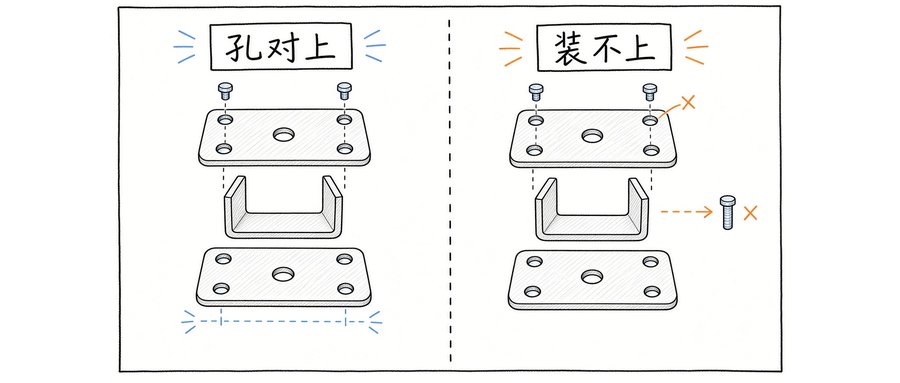
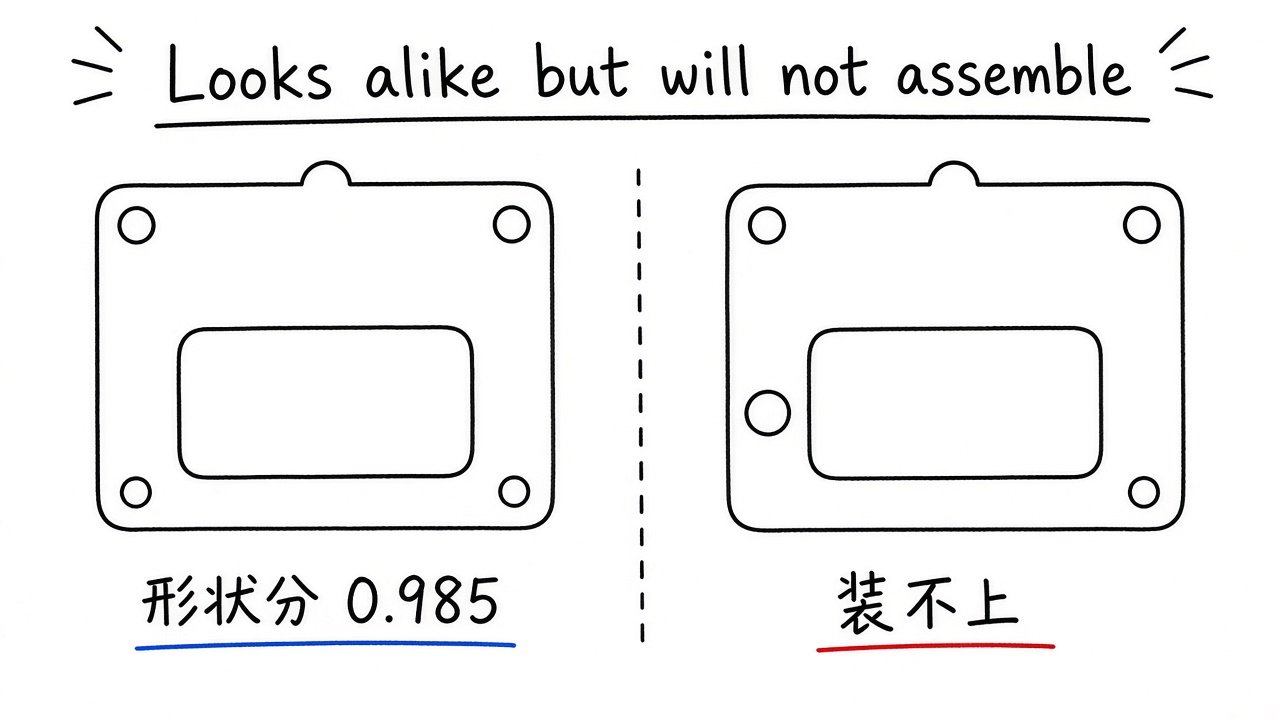
第二个是孔位。沉头螺栓孔沿板移动,体积不变。到 4 mm 时形状分仍有 0.985,螺栓已经穿不进。Normal 借用 CADGenBench 的夹具:螺栓路径必须是空的(keep-out),凸台必须是实的(keep-in)。该孔的 keep-out 掉到 0.3,综合分掉到 0.944,不通过。1.5 mm 及以内仍通过,因为其他夹具还对得上 1。
在我看来,4 mm 这个例子比排行榜更值得记住。要交付的是装得上,不是看起来像。
三、FrontierCAD 怎么打分
零件分先做刚体对齐,只许平移和旋转,不许镜像或缩放。综合分 = 0.4 × 形状 + 0.4 × 夹具 + 0.2 × 拓扑。形状是体积交并比和表面 F1 的平均,拓扑比实体、通孔和内部空腔,不是有效实体就记 0。0.97 及以上算通过 12。 原报告图示与交互演示
夹具由 Jiggen 从参考 STEP 的几何自动生成,不用语言模型。它为孔、销、槽、凸台等定位和紧固区域生成检查区域:螺栓路径要留空(keep-out),凸台应有实体(keep-in)。参考件在某个夹具上的体积交并比低于 0.98,就删掉该夹具。2026 年 8 月 10 日的报告里,39 个零件共生成 3,218 个夹具,每件有 11 到 446 个 1。这是基于参考件的几何校核,不是 AI 自主推断孔轴配合、紧固顺序和完整装配意图。 原报告图示与交互演示
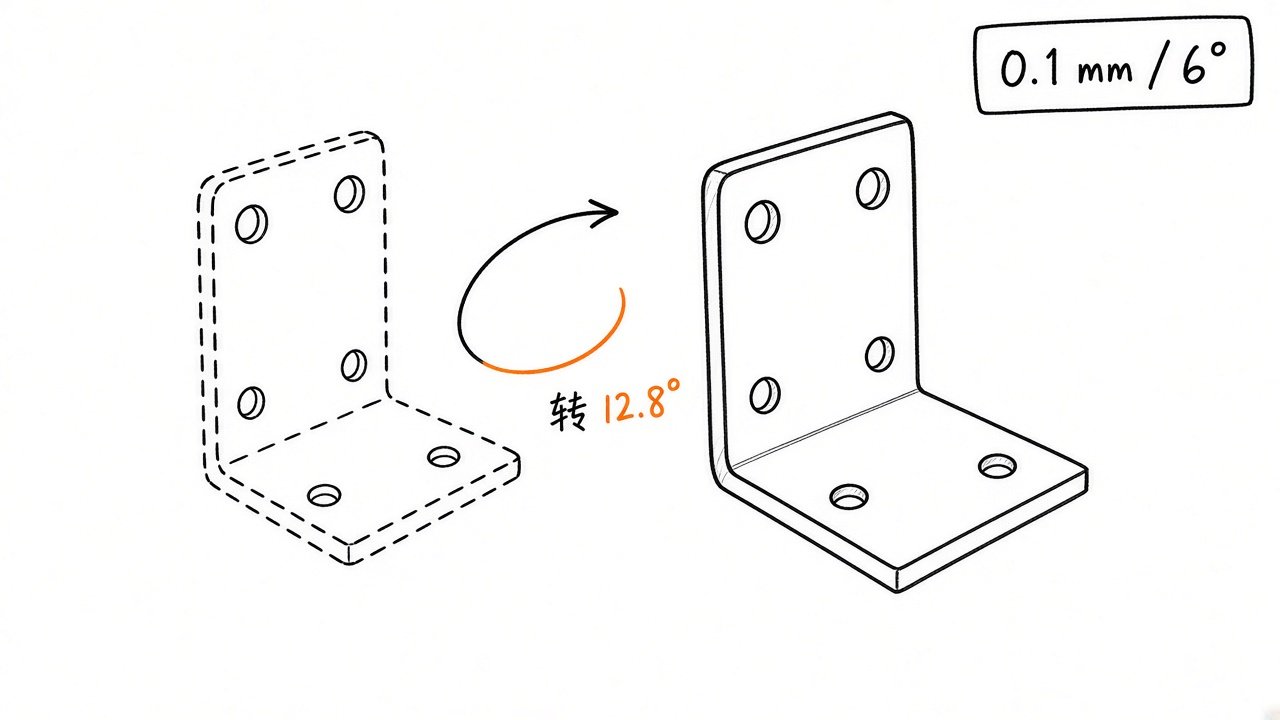
装配按形状配对,同形螺钉对调不扣分,名字和文件顺序不算。装配整体先对齐,只留相对位置。每个零件得 1 / (1 + d)。技术报告写,d 取形状误差和位置误差中较大的一个;1 个单位是 0.1 mm 或 6°,不论零件大小。装配分等于各零件分数之和,除以参考件数和候选件数中较大的一个,所以缺件、多件都会拉低分数。0.97 算通过 12。概述页写平移和转动相加,技术报告写取较大者,两处不一致,正文按技术报告。
8 零件的受控装配里,整体转动带来的分数变化小于 2 × 10⁻¹⁰;L 形支架单独转 12.8°,记录分 0.915。六角头每 60° 外观相同,绕自身轴线转不该扣分 1。
这套流程里,AI 负责生成零件或试摆装配;几何算法负责对齐、匹配、测量形状与关键区域;0.4/0.4/0.2 的权重和 0.97 的通过线是评测规则。我认为分开检查接口和外形是对的,但这里还没有能判断产品需求、设计意图与装配工艺的规则引擎。夹具来自参考模型,证明的是候选件接近参考件,不是这套设计在你的产品里一定合理。
四、报告的测试成绩
零件通过线 0.97。表内是技术报告的三位小数;概述页把最高平均分写成 0.63,单次最高 0.96,并写没有任何模型通过这 39 个零件,模型仍然不能完美重建复杂零件 12。
- GPT-6 Astra — 运行环境:codex · ultra;平均分:0.633;有分的试验:39/39;通过:0/39
- Claude Fable 5.1 — 运行环境:claude-code · max;平均分:0.582;有分的试验:39/39;通过:0/39
- GLM 5.3 Flash — 运行环境:opencode · max;平均分:0.333;有分的试验:6/39;通过:0/6
- Gemini 3.8 Flash — 运行环境:gemini-cli · high;平均分:0.332;有分的试验:39/39;通过:0/39
- Muse Spark 1.3 — 运行环境:muse-code · xhigh;平均分:0.332;有分的试验:39/39;通过:0/39
- DeepSeek V4 Flash Vision — 运行环境:opencode · max;平均分:0.305;有分的试验:39/39;通过:0/39
- Grok 4.6 — 运行环境:grok-build · xhigh;平均分:0.255;有分的试验:39/39;通过:0/39
装配上,概述页写 Astra 平均分 0.71、16 套里通过 4 套,通过数最多;区间很宽,模型之间的小差距没有意义 12。
- GPT-6 Astra — 平均分:0.713;有分的试验:16/16;通过:4/16
- Claude Fable 5.1 — 平均分:0.618;有分的试验:16/16;通过:3/16
- Gemini 3.8 Flash — 平均分:0.371;有分的试验:16/16;通过:2/16
- DeepSeek V4 Flash Vision — 平均分:0.339;有分的试验:16/16;通过:2/16
- Grok 4.6 — 平均分:0.334;有分的试验:16/16;通过:2/16
- Muse Spark 1.3 — 平均分:0.266;有分的试验:15/16;通过:1/15
- GLM 5.3 Flash — 平均分:0.075;有分的试验:16/16;通过:0/16
原报告图示与交互演示 装配零件数从 5 到 179,中位数 43.5。零件数和分数只有弱相关,因为重复螺栓容易摆对。20 件及以下平均分 0.44,超过 50 件是 0.36 1。
GLM 5.3 Flash 有 33 个零件因输出长度上限没交出 CAD,0.333 只覆盖 6 次有分试验;若这 33 次按 0 分计,平均分是 0.051。Muse Spark 1.3 有 1 个装配因内存不足无分;若按 0 分计,装配平均分是 0.250。评分器拒绝的候选按 0 分计 12。
技术报告写,任务是看完成绩后才选定的,删了 59 个任务,其中包含所有有模型通过的零件。通过率为 0 有一部分来自选题,分数也比不筛选时更低。39 个里有 8 个图纸不完整,因为难,先留着,以后再改。2026 年 10 月 5 日改过一批图纸,分数仍用改前输入,没有重跑 12。装配分还是临时的:未做精确 B-Rep 比对。14 次通过有 11 次落在 2 个任务上,分数可一致到小数点后六位及以上,不能确认零件精确重合 2。
复杂零件按图重建和整套装配直接交付,现在都不能整段交给 AI。但“39 个全没通过”不能单独当能力结论——后面要和选题筛选一起看。
五、报告启示:现状与我的看法
现状。 FrontierCAD 测的是:按工程图重建零件 STEP,以及把现成零件按装配图摆到位。零件题上 7 个模型全部 0/39 过线;装配题最多 Astra 4/16。人工基线也不轻松:平均分 0.691,39 个里只有 1 个过线。成绩还要和选题方式一起看——任务是看完成绩后筛选的,删过有模型通过的零件,所以“全没过”不能单独当能力结论。技术上,报告侧重装得上、摆到位:夹具与相对位姿可以查;完整装配关系、配合约束、关节运动,以及特征树、参数和设计意图,都不在这套评测里。后一类更接近 CAD Arena 的范围 12。
报告结论。 以下是 Normal / FrontierCAD 原文的结论与口径,不是我的引申 12:只比外形会放过装不上的零件(例如孔偏 4 mm 时形状分仍可到 0.985),因此要用夹具一类配合向几何指标,而不能只靠形状分;当前模型“仍不能完美重建复杂零件”,本轮 39 个零件无一过线;装配相对好一些,最好成绩约 4/16,但样本小、区间宽,装配分还是临时的(未做精确 B-Rep 比对,部分高分不能确认零件精确重合);装配评测也不查配合约束、关节与运动;任务是看完成绩后才删定的,删掉了所有有模型通过的零件,因此零件通过率为 0 有一部分来自选题,分数也比未筛选时更低。
我的观点。 AI 可以按图试摆一版、试着重建外形;配合面、孔轴、止口这类装配要素,仍须工程师自己查。不能把整段装配交给 AI 当终审,也不能只看渲染图或形状分就签字。本报告尚不能证明 AI 已能自主选取独立零件、建立完整配合约束并完成整套装配放行。
本文配图为原稿的概念示意,不是产品实测截图。英文版使用对应英文配图,图内文字与图注均为英文。
延伸阅读:工程智能体与 CAD 工作流。